こんにちは、みっちゃんです。
データ分析において、2変数の関係性を可視化する「散布図」は非常に強力なツールです。しかし、「各データ点が持つ第3の数値(特徴量)の大きさ」を同時に表現したい場合、通常の散布図では情報が不足してしまいます。
そこで役立つのが、データ値に応じて連続的に色を変化させる「ヒートマップ風の色分け(グラデーションマッピング)」です。
本記事では、無料の統計解析言語「R」と対話的グラフ作成ライブラリ「plotly」を用いて、散布図の要素を連続値で美しく色分けする方法を分かりやすく解説します。基本操作から、主成分分析(PCA)などの次元圧縮結果と組み合わせた高度なデータ可視化まで網羅していますので、ぜひ手元の環境で試してみてください。(※Rの基礎設定やインストール手順についてはこちらの記事をご参照ください。)
1. なぜRの標準描画ではなく「plotly」を使うのか?
Rの標準関数(plot())や一般的な静的グラフライブラリでも色分けは可能ですが、実務や研究でグラデーション散布図を描く際にはplotlyパッケージが圧倒的におすすめです。
| 比較項目 | R標準グラフィックス (plot) | plotly パッケージ |
|---|---|---|
| 色の連続指定 | カラーパレットの手動マッピングが必要 | color指定だけで自動グラデーション化 |
| インタラクティブ性 | 静的画像(拡大・ツールチップ不可) | ホバー表示、拡大・縮小、凡例操作が可能 |
| カラーバー(凡例) | 自作コードが必要で手間がかかる | 連続値に応じたカラーバーが自動生成 |
| 出力形式 | PNG / PDFなど | HTMLで動的埋め込み・Web出力可能 |
「地図上の標高によって色を変えるサーモグラフィ」のように、データの大きさを視覚的なグラデーションとして直感的に理解させたい場合、plotlyを使えばわずか数行のコードで実現できます。
2. 【基本編】Rとplotlyで連続値グラデーション散布図を作成する手順
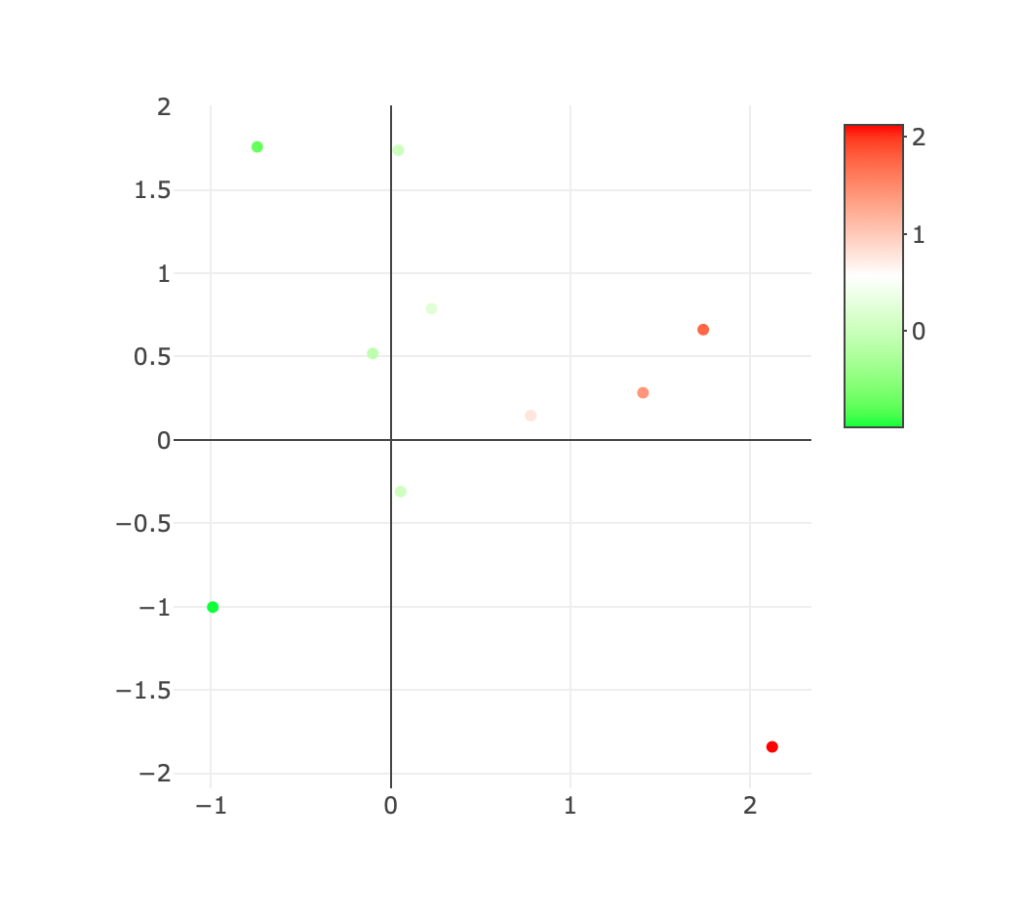
まずはシンプルな2次元散布図を作成し、x軸の数値の大きさに合わせてデータ点の色を緑から赤へ変化させてみましょう。
Step 1: データの準備と型チェック(data.frame化)
正規分布に従う乱数を10個ずつ生成し、plotlyが最も扱いやすい「データフレーム(data.frame)」形式にまとめます。
# パッケージのインストールと読み込み(初回のみ要install)
# install.packages("plotly")
library(plotly)

# サンプルデータの生成(標準正規分布乱数)
set.seed(123) # 再現性の確保
x <- rnorm(10)
y <- rnorm(10)

# データフレームの作成
data <- data.frame(x = x, y = y)

# データ構造と型の確認
class(data)
# [1] "data.frame"
ワンポイント解説:データ型の確認方法
plotlyでスムーズにグラフを描画するには、データ構造がdata.frame形式であり、色分けに使いたい列が数値型(numeric)になっていることが重要です。class(data$x)で"numeric"と返ってくれば準備完了です。
Step 2: plot_ly関数の構文と~(チルダ)の意味解説
plotlyで散布図を描く基本関数はplot_ly()です。以下のいずれの記法でも描画できます。
# 1. 従来型の明示的指定
plot_ly(data, x = data$x, y = data$y, color = data$x, colors = c("green", "white", "red"))
# 2. チルダ(~)を使用した推奨記法
plot_ly(data, x = ~x, y = ~y, color = ~x, colors = c("green", "white", "red"))記号「~(チルダ)」の役割とは?
Rのplotlyでは、第1引数にデータフレーム(data)を指定した上で、列名の前に~を付けると「data内の列を参照する」という意味になります。data$xと何度も書く必要がなくなり、コードがすっきり読みやすくなります。
実行すると、WebブラウザまたはRStudioのViewerパネルに以下のようなグラデーション散布図が出力されます。
3. 【応用編】次元圧縮(PCA)結果を特定の特徴量でヒートマップ風色分け
実務のデータ分析では、「多数の変数を持つ多次元データを2次元に圧縮(次元圧縮)し、そこに別の着目したい数値を重ね合わせて観察する」というアプローチが頻繁に使われます。(※次元圧縮の概念やSleepwalkパッケージについてはこちらの解説記事も併せてご覧ください。)
ここでは、Rに標準搭載されている自動車データセット「mtcars」を用い、主成分分析(PCA)で圧縮した散布図上に、燃費性能(mpg)の大きさを色として重ね合わせます。
Step 1: 主成分分析(PCA)の実行とデータ統合
まず、変数の単位を揃えるために標準化(scale)を行ってから主成分分析を実行します。
# 1. データの標準化とPCAの実行
scaled_data <- scale(mtcars)
pca_result <- prcomp(scaled_data)

# 2. 第1主成分(PC1)、第2主成分(PC2)、および色分け用変数(mpg)の抽出
pca_df <- data.frame(
  PC1 = pca_result$x[, 1],
  PC2 = pca_result$x[, 2],
  mpg = mtcars$mpg
)

# 先頭行の確認
head(pca_df)
#                   PC1        PC2  mpg
# Mazda RX4   -0.6468627  1.7081142 21.0
# Mazda RX4 Wag -0.6194832  1.5256219 21.0
# Datsun 710  -2.7356243 -0.1441501 22.8
Step 2: PC1/PC2プロット上に特徴量をマッピングする
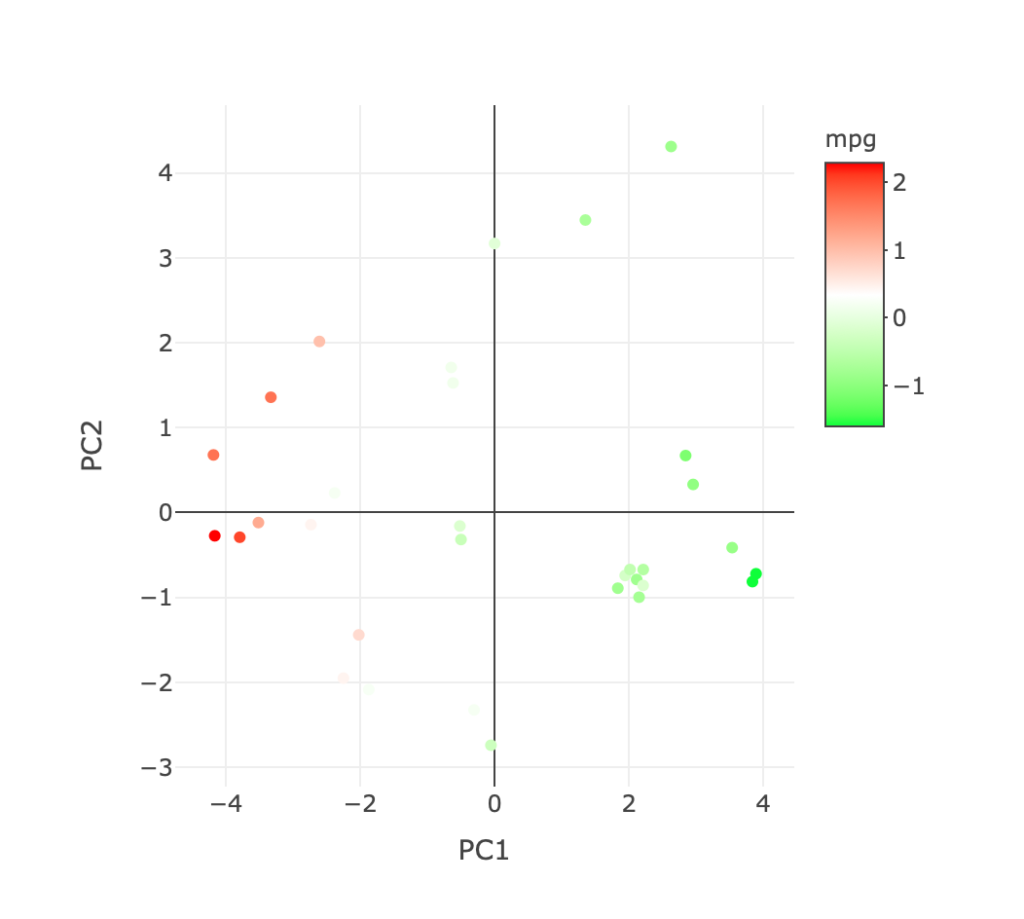
抽出したデータフレームを使って、横軸をPC1、縦軸をPC2とし、mpg(燃費:Miles Per Gallon)の値でグラデーション色分けを行います。
# PCAプロットの可視化(mpgでグラデーション色分け)
plot_ly(
  pca_df,
  x = ~PC1,
  y = ~PC2,
  color = ~mpg,
  colors = c("green", "white", "red"),
  type = "scatter",
  mode = "markers"
)
このグラフから読み取れるデータ解釈のポイント
生成されたグラフを観察すると、「赤色(高燃費・省エネ車)のデータ点はPC1がマイナスの領域(左側)に集中し、緑色(低燃費・大型車)のデータ点はPC1がプラスの領域(右側)に分布している」ことが一目で分かります。つまり、第1主成分(PC1)軸は「車の燃費効率・サイズ感」を強く反映していることが視覚的に証明できます。
4. グラフの表現力を高めるカラーグラデーションカスタマイズ技
plot_ly関数のcolors引数を調整することで、より見やすく美しいカラーパレットに変更できます。
1. 組み込みパレット(rainbowなど)を使用する
# 虹色パレット(12段階の解像度指定)
plot_ly(pca_df, x = ~PC1, y = ~PC2, color = ~mpg, colors = rainbow(12))
2. ColorBrewerパレット(ViridisやBluesなど)を使用する
データ可視化の世界で推奨される「色覚バリアフリー(カラーユニバーサルデザイン)」に対応したパレット群も直接指定可能です。
# 青〜黄〜緑の認知しやすいViridisパレットを指定
plot_ly(pca_df, x = ~PC1, y = ~PC2, color = ~mpg, colors = "Viridis")

# 赤〜青のパレットを指定
plot_ly(pca_df, x = ~PC1, y = ~PC2, color = ~mpg, colors = "RdBu")
5. よくあるエラーと対処法(データ型・チートシート)
Rのplotlyで連続値色分けを行う際によく直面するトラブルと対処法をまとめました。
| 発生する現象 / エラー | 原因 | 解決策 |
|---|---|---|
| 連続グラデーションにならず離散値(カテゴリ)の色分けになる | colorに指定した列がfactor型やcharacter型になっている |
as.numeric(data$col)で数値型に変換してから描画する |
Error: Column name not found が発生する |
~(チルダ)を付け忘れている、または列名が間違っている |
~列名のようにチルダを付与し、colnames(data)で正確な名称を確認する |
| カラーバー(凡例)が表示されない | データ内にNA(欠損値)が含まれている |
na.omit(data)で欠損値を除去して試す |
6. まとめ
本記事では、R言語とplotlyパッケージを使って、散布図の要素を連続値でヒートマップ風に色分けする方法を解説しました。
- plotlyの利点: 静的グラフと異なり、数行のコードで対話的(インタラクティブ)かつ連続グラデーションな散布図が作れる。
- 基本文法:
plot_ly(data, x = ~x, y = ~y, color = ~連続値列, colors = パレット) - 多次元分析への応用: PCAなどの次元圧縮軸(PC1, PC2)上に元の特徴量をマッピングすることで、データ構造の解釈が飛躍的に容易になる。
論文やレポーティング、Web上での可視化において「説得力のあるグラフ」を作成したい方は、ぜひ本手法を活用してみてください。