「アルゴリズムの勉強を始めたけれど、『二分探索』や『ハッシュ法』の仕組みがピンとこない…」
「線形探索・二分探索・ハッシュ探索って、結局どれが一番速いの?」
ITパスポートや基本情報技術者試験、プログラミング学習の初期に必ず登場するのが「探索アルゴリズム(Search Algorithm)」です。
大量のデータの中から「目的のデータ」を効率よく探し出す方法は、日常の身近なシチュエーション(本のページめくりや下駄箱の靴探しなど)に置き換えると一気に理解が深まります。
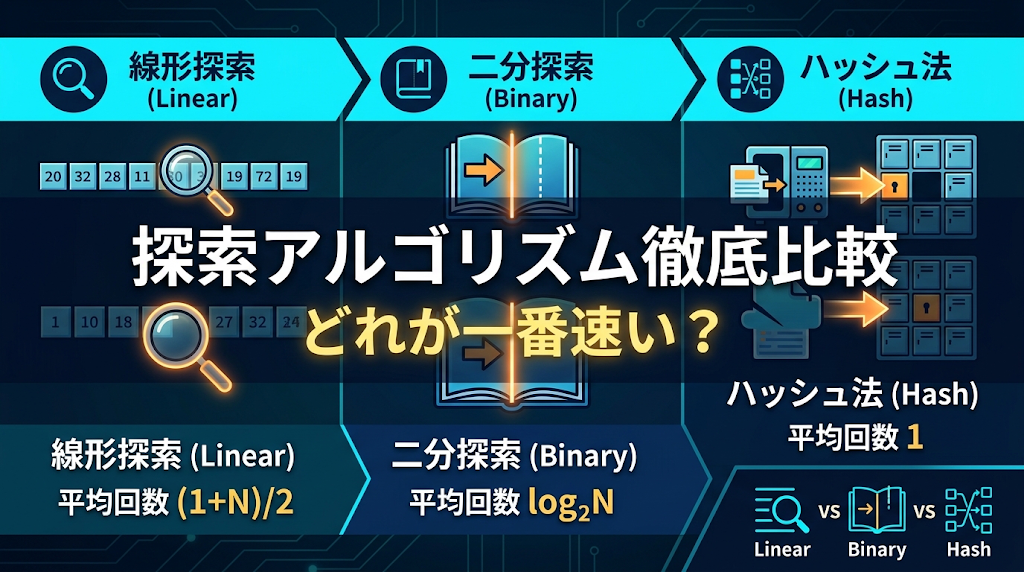
本記事では、基本となる3大探索手法「線形探索法」「二分探索法」「ハッシュ法」の仕組み・特徴・計算量(オーダー記号)の違いを、わかりやすい例え話を交えて徹底解説します!
目次
1. 探索アルゴリズムとは?大量データから一瞬で目的値を探す技術
コンピュータの最も重要な役割の1つが、配列やデータベースの中に格納された膨大なデータの中から、目的のデータを素早く探し出す「探索(検索)」処理です。
人間であれば、全体をパッと俯瞰して目的の数値を見つけ出すことができます。しかし、コンピュータは「配列の1番目の要素」「2番目の要素」というように、原則としてメモリ上の位置を1点ずつ指定して中身を確認するしかありません。
そのため、「どのように順序立てて探索するか」というアルゴリズムの手法によって、データの検索スピードは数万倍以上も変わってきます。
2. 線形探索法(リニアサーチ):端から1つずつ確認する最もシンプルな方法
目的のデータを探す最も直感的で基本となる方法が「線形探索法(リニアサーチ)」です。
・仕組みと手順:バラバラな並びでも探せる
配列の「先頭(端)から順番に1つずつ」目的のデータと一致するか照合していく手法です。
例えば、次のようなランダムに並んだ10個の数値配列から「4」を探すケースを考えてみましょう。
| 5 | 6 | 2 | 9 | 4 | 8 | 1 | 7 | 10 | 3 |
- 1番目:5 → 4ではない(次へ)
- 2番目:6 → 4ではない(次へ)
- 3番目:2 → 4ではない(次へ)
- 4番目:9 → 4ではない(次へ)
- 5番目:4 → 発見!探索終了
例えるなら、「バラバラに積まれた書類の山を、上から1枚ずつめくって探す作業」です。データの並び順が整列していなくても使えるのが最大の強みです。
・探索回数と計算量:データ量 N に比例
データ数を N とした場合の探索回数は以下のようになります。
- 最良の場合: 1回(先頭にあった場合)
- 最悪の場合: N 回(末尾にあるか、存在しない場合)
- 平均の探索回数: (1 + N) / 2 回
オーダー記号(計算量)で表すと O(N) となり、データ数が10倍になれば、探す時間も10倍に増えます。
3. 二分探索法(バイナリサーチ):整列済みデータを半分ずつ絞り込む方法
データがあらかじめ小さい順(昇順)などに並んでいる場合、圧倒的に高速化できる手法が「二分探索法(バイナリサーチ)」です。
・仕組みと手順:辞書や電話帳をめくるイメージ
昇順にソートされた10個の配列から「4」を探す場合を見てみましょう。
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
- 中央値と比較する: 配列の中央にあるデータ(例えば5番目の「5」)を見る。
- 範囲を半分に絞る: 目的の「4」は中央値「5」より小さい。したがって、「6〜10」の右半分の領域には絶対存在しないため、探索対象を「左半分の1〜4」だけに絞り込む。
- 操作を繰り返す: 絞り込んだ範囲の中央値を算出し、目的の「4」に一致するまで半分に割る処理を繰り返す。
例えるなら、「国語辞典で単語を探すとき、真ん中あたりを開いて『あ行』か『さ行』かで前後のページを一気に捨てて絞り込む作業」です。
・探索回数と計算量:爆速の O(log₂N)
毎回候補が半分(1/2)になるため、最大でも log2N 回の操作で完了します。
計算量は O(log2N) と表されます。例えば、データ数が100万件あった場合、線形探索では平均50万回の比較が必要ですが、二分探索ならわずか「約20回」の比較で見つけ出すことができます!
4. ハッシュ法(ハッシュ探索):ハッシュ関数で一発計算して取り出す方法
データを「探す」のではなく、「格納されている位置を計算して直接取り出す」という画期的な手法が「ハッシュ法(ハッシュ探索)」です。
・仕組みと手順:番号指定の下駄箱から靴を取り出すイメージ
ハッシュ法では、あらかじめ「ハッシュ関数」という計算式を用いて、データから保存場所(インデックス番号)を決定して格納しておきます。
例えば「データを 7 で割った余り(data % 7)」をハッシュ関数と定義した場合:
- データ「18」を保存する場合:18 ÷ 7 = 2 あまり 4 → インデックス「4」の場所に保存
- 探す時:「18」を探したいなら、18 ÷ 7 の余り「4」を計算し、配列の4番目を直接見れば一発で取り出せる!
例えるなら、「自分の出席番号と同じ番号の下駄箱に靴を入れ、帰りは探すことなく自分の番号の箱を直接開けるシステム」です。
・注意点:データ重複(ハッシュ衝突・シノニム)への対策
非常に効率的なハッシュ法ですが、異なるデータから同じ余り(計算結果)が算出されてしまうことがあります。これを「ハッシュ衝突(コリジョン)」、衝突したデータ同士を「シノニム」と呼びます。
衝突が発生した場合は、隣の空き場所にずらして格納する「オープンアドレス法」や、同じインデックスにリスト構造で繋げて保持する「チェイン法」といった対策が必要になります。
5. 【徹底比較】3つの探索アルゴリズムの計算量・特徴一覧表
各探索アルゴリズムの特徴や計算量をまとめました。
| アルゴリズム名 | 平均計算量(時間) | 事前準備(ソート等) | メリット・デメリット |
|---|---|---|---|
| 線形探索法 (リニア) |
O(N) | 不要 (どんな順序でも可) |
【長所】実装が最も簡単。 【短所】データ数が増えると遅い。 |
| 二分探索法 (バイナリ) |
O(log2N) | 必須 (あらかじめソートが必要) |
【長所】大量データでも非常に高速。 【短所】事前の並び替えコストがかかる。 |
| ハッシュ法 (ハッシュ探索) |
O(1) (ほぼ1回) |
専用構造が必要 (ハッシュ表の作成) |
【長所】計算で一発検索できる。 【短所】ハッシュ衝突対策やメモリ管理が必要。 |
6. まとめと試験・実務での使い分け
本記事のポイントをまとめます。
本記事のまとめ
- 線形探索: 並び順が不揃いな小規模データに適した基本手法。計算量は O(N)。
- 二分探索: ソート済み配列に対して真ん中で割って絞り込む高速手法。計算量は O(log2N)。
- ハッシュ法: ハッシュ関数で格納場所をピンポイント計算して取り出す最強手法。計算量は O(1)。
資格試験対策としては、「二分探索=ソート前提」「ハッシュ法=ハッシュ関数と衝突回避」というセットキーワードを押さえておくのが合格への近道です!
7. 参考文献・おすすめ書籍
本記事の解説にあたり、以下の文献・参考書を参考にしています。アルゴリズムや基本情報技術者試験の対策を深く学びたい方におすすめです。
きたみりゅうじ『キタミ式イラストIT塾 応用情報技術者』技術評論社(Amazon)