目次
こんにちは、みっちゃんです。
大量のアクセスが発生するWebサービスや、膨大な演算処理をこなすデータ解析現場に不可欠な技術が「クラスタリングシステム(クラスタ構成)」です。
「クラスタリングって何?」「負荷分散、HA、HPCってどう違うの?」と疑問に思ったことはありませんか?
単一のサーバー(スタンドアロン)では限界がある処理性能や障害耐性を、複数のコンピュータを連携させて解消するのがクラスタリングの役割です。基本情報技術者・応用情報技術者試験の頻出分野であるとともに、実務でのインフラ設計やクラウド構築でも必須の知識となっています。
この記事では、クラスタリングシステムの基礎概念、3つの運用形態(負荷分散・HA・HPC)の特徴と違い、フェールオーバ/フェールバックの仕組み、そして2026年現在のコンテナ・AI時代における最新動向まで分かりやすく徹底解説します!
1. クラスタリングシステム(クラスタ構成)とは?基本概念をわかりやすく解説
クラスタリング(Clustering)とは、複数の独立したコンピュータ(サーバー)をネットワークで連結し、ユーザーやアプリケーションから見て「全体で1つの巨大なシステム」として機能させる技術のことです。結合された1台1台のサーバーを「ノード」と呼びます。
身近な例えで言えば、「1人の天才シェフに頼るのではなく、複数の料理人がチームを組んで調理場を回す仕組み」です。1人では捌ききれないオーダーも、チームで分担すればスムーズに処理できますし、1人が体調を崩しても他のメンバーがカバーできます。
- 拡張性(スケーラビリティ): サーバーを追加(スケールアウト)するだけで処理能力を向上できる。
- 高可用性(アベイラビリティ): 1台が故障してもシステム全体を止めることなく運用を継続できる。
- コスト効率: 高価なスーパーコンピュータを導入する代わりに、汎用サーバーを組み合わせることで費用を抑えられる。
2. クラスタリングシステムの主要な3つの運用形態
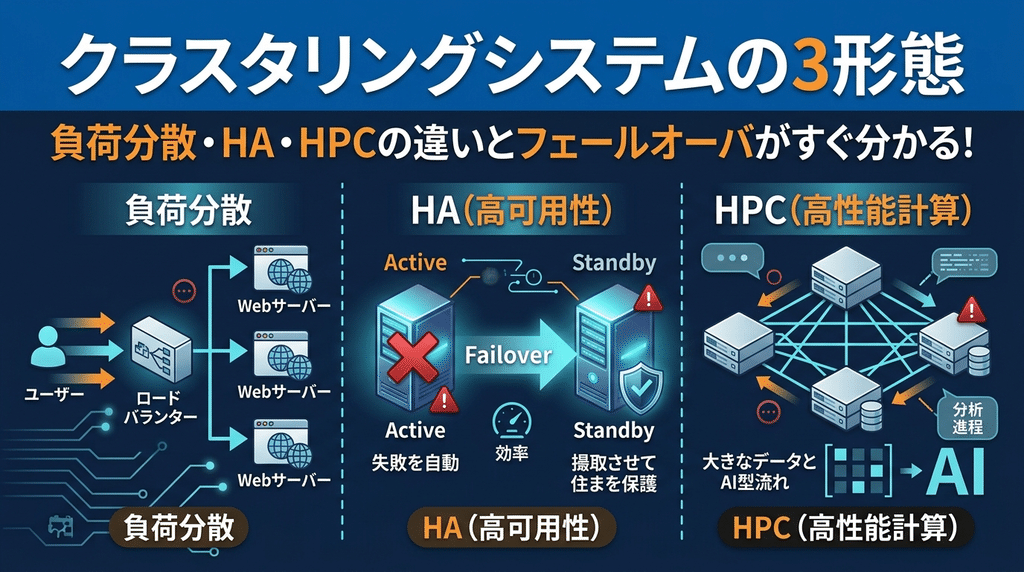
クラスタリングシステムは、その目的に応じて大きく「負荷分散クラスタ」「HAクラスタ」「HPCクラスタ」の3つの形態に分類されます。
① 負荷分散クラスタ(ロードバランシングクラスタ):アクセス集中を捌く
負荷分散クラスタ(Load Balancing Cluster)は、集中するネットワークトラフィックや処理リクエストを、複数のサーバーへ均等または効率的に振り分ける(分散する)ためのシステムです。
システムの最前線に「ロードバランサー(負荷分散装置)」を設置し、後ろに控えるWebサーバー群へアクセスを振り分けます。
- 主な用途: ECサイトのセール時やニュースサイトなど、膨大なアクセスが発生するWebシステム。
- 身近な例え: テーマパークの混雑したチケット売り場で、案内係が空いている窓口へ順次来場者を誘導するイメージ。
② HAクラスタ(High Availability Cluster):止められないシステムを守る
HA(High Availability:高可用性)クラスタは、システムの連続稼働率を高め、障害発生時にもサービス低下や停止を最小限に抑えるためのシステムです。
「可用性(Availability)」とは、必要なときにいつでもサービスを利用できる状態の維持を意味します。HAクラスタでは、稼働中のメインサーバー(アクティブ機)と、待機中のサブサーバー(スタンバイ機)を準備し、常に相互の健全性を監視(ハートビート信号)します。
- 主な用途: 24時間365日の連続稼働が求められる金融システム、医療システム、基幹系データベース。
- 身近な例え: 飛行機の「デュアルエンジン」。片方のエンジンが停止しても、もう片方のエンジンで安全に飛行を継続できる仕組み。
③ HPCクラスタ(High Performance Computing Cluster):大規模データ演算を高速化
HPC(High Performance Computing:高性能計算)クラスタは、複数のサーバーの計算リソース(CPUやGPU)を結合して高度な並列処理を行い、巨大な計算タスクを超高速で処理するためのシステムです。
「スーパーコンピュータ」の多くも、このHPCクラスタの思想と技術を基盤に構築されています。研究開発や技術計算の現場で幅広く活用されています。
- 主な用途: 気象予測、遺伝子解析、構造解析、金融リスクシミュレーション、生成AIモデルの学習。
- 身近な例え: 膨大な計算問題を1人で解くのではなく、何百人もの数学者が分担して同時に計算し、最後に回答を持ち寄るイメージ。
3. HAクラスタの重要用語「フェールオーバ」と「フェールバック」の仕組み
HAクラスタを理解するうえで、必ず押さえておくべき最重要概念が「フェールオーバ(Failover)」と「フェールバック(Failback)」です。
- フェールオーバ(Failover): 主稼働中のサーバー(アクティブ機)に障害が発生した際、即座に待機中のサーバー(スタンバイ機)へ処理と権利を自動的に切り替えて業務を継続させる動作。
- フェールバック(Failback): 障害を起こした元のサーバーの修理・復旧が完了した後、待機機から元のメインサーバーへ処理を切り戻す動作。
これらの切り替えが人間(運用管理者)の手を介さずにミリ秒〜数秒単位で自動実行されることで、ユーザーは障害が発生したことすら気付かずにサービスを使い続けることができます。
4. 3大クラスタリングシステム比較一覧表
それぞれの運用形態の主な特徴、目的、構成のポイントを一覧表に整理しました。
| 項目 | 負荷分散クラスタ | HAクラスタ | HPCクラスタ |
|---|---|---|---|
| 主目的 | アクセス・処理の分散 | 高可用性・障害耐性の確保 | 超高速な大規模並列計算 |
| 重視する指標 | スループット、応答速度 | 稼働率(99.999%など) | FLOPS(浮動小数点演算性能) |
| キーテクノロジー | ロードバランサー (L4/L7) | ハートビート監視、共有ストレージ | 高速通信(InfiniBand)、MPI |
| 代表的な活用例 | 大規模Web/APサーバー | データベース、金融オンライン基盤 | 科学技術計算、AIモデル学習 |
5. 2026年最新トレンド:クラウドネイティブ(Kubernetes)とAI時代のクラスタ構成
かつてのクラスタリングは、オンプレミス環境で物理物理サーバーを複数台並べてネットワーク構築するスタイルが主流でした。しかし、2026年現在のモダンシステムではクラウドおよびコンテナ技術の普及により大きく変化しています。
- Kubernetes(K8s)によるコンテナクラスタリング: アプリケーションをコンテナ単位で管理し、自動スケール・自己修復(オートヒーリング)・オートバランシングを標準機能として提供するコンテナオーケストレーションがインフラの標準となっています。
- クラウドマルチリージョンHAクラスタ: AWS、Google Cloud、Azureなどのクラウド上で、地理的に離れた複数のデータセンター(リージョン)跨ぎでHAクラスタを組むことで、大規模災害(DR対策)にも耐える設計が一般化しています。
- GPUベースのAI HPCクラスタ: 大規模言語モデル(LLM)や生成AIの進化に伴い、多数のNVIDIA GPUを高速インターコネクトで繋いだAI専用HPCクラスタの需要が急増しています。
6. まとめ・参考文献
今回は、システム運用・設計の要となるクラスタリングシステムについて解説しました。
- クラスタリング: 複数のコンピュータを束ねて1つの高機能なシステムとして動作させる技術。
- 負荷分散クラスタ: アクセス集中を均等に分散(Webサーバー向け)。
- HAクラスタ: 障害時にフェールオーバして連続稼働を維持(DB・重要基盤向け)。
- HPCクラスタ: 並列計算により超高速処理を実現(科学計算・AI学習向け)。
クラスタリングの各形態とその目的を正しく理解しておくことで、システム開発や資格試験(応用情報技術者など)だけでなく、現代のクラウドインフラ構築でも的確な構成判断ができるようになります。